Optimisation et estimation avec R
Le package stats, installé par défaut avec R, contient plusieurs fonctions permettant de résoudre des problèmes d'optimisation et d'estimation numérique. Elles sont très utiles lorsqu'une solution ne peut pas être obtenue facilement par une formule mathématique ou lorsqu'on souhaite déterminer la valeur d'un paramètre qui minimise une erreur, maximise un résultat ou satisfait une équation.
Rechercher une solution à une équation
La fonction uniroot() recherche une valeur qui annule une fonction mathématique. Elle permet donc de résoudre numériquement une équation de la forme \(f(x) = 0.\)
Cette opération est appelée recherche d'une racine. Elle peut être utile en économie, par exemple pour déterminer le niveau de production auquel le résultat d'une entreprise devient nul, ou en finance pour rechercher un taux qui satisfait une équation.
Exemple : résoudre \(x^2-2=0\). La solution positive est \(\sqrt{2}\), mais supposons que nous ne le sachions pas.
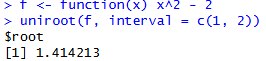
Le résultat est une estimation de la racine, proche de 1,4142. L'intervalle c(1, 2) indique à R où il doit chercher (la fonction est négative en 1 et positive en 2). Cette différence de signe permet de garantir l'existence d'au moins une racine dans l'intervalle si la fonction est continue.
Si plusieurs racines peuvent exister, la fonction recherche celle qui se trouve dans l'intervalle retenu, sans garantir qu'il s'agit de la seule solution.
Notez que R renvoie aussi des informations sur le résultat et sur la manière dont il a été obtenu. Comme il est rare que ceci nous intéresse, on peut modifier le script pour n’obtenir que la solution.
f <- function(x) x^2 – 2
solution <- uniroot(f, interval = c(1, 2))$root
print(solution)
Rechercher un minimum ou un maximum
Avec optimize(), il ne s'agit plus de trouver une valeur pour laquelle une fonction s'annule, mais de déterminer celle qui rend cette fonction aussi petite ou aussi grande que possible sur un intervalle donné.
f <- function(x) -(x - 3)^2 + 10
optimize(f, interval = c(0,5), maximum = TRUE)
On obtient la valeur de \(x\) pour laquelle la fonction admet un maximum dans l’intervalle défini et celle de \(y,\) valeur de ce maximum.

Par défaut, optimize() recherche un minimum. L'argument maximum = TRUE inverse donc l'objectif.
Cette fonction convient aux problèmes comportant un seul paramètre. Elle est simple à employer, mais ne garantit pas de trouver le meilleur résultat global si la fonction possède plusieurs minimaux ou maximaux locaux.
Optimiser plusieurs paramètres
Quand le problème dépend de plusieurs paramètres, optim() constitue un outil plus général. Cette fonction cherche à minimiser une fonction objectif, c'est-à-dire une expression qui mesure le coût, l'erreur ou l'écart à réduire.
Pour illustrer le principe sans charger le programme de calculs, utilisons une fonction objectif simple.
\( f(a,b)=(a-2)^2+(b-5)^2\)
Son minimum vaut zéro lorsque \(a=2\) et \(b=5\).
f <- function(p) { (p[1] - 2)^2 + (p[2] - 5)^2 }
optim(par = c(0, 0), fn = f)
L'argument par fournit les valeurs initiales des paramètres : ici, \(a=0\) et \(b=0\). L'argument fn désigne la fonction à minimiser. R renvoie notamment les valeurs estimées des paramètres dans par.
Les fonctions d’optimisation de stat sont comme des solveurs qui cherchent une solution par calcul itératif. Elles fournissent des approximations numériques, souvent très précises, mais la fiabilité du résultat dépend de la méthode utilisée et des propriétés du problème. C'est précisément ce qui distingue le calcul numérique d'une résolution analytique. En l’occurrence :
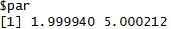
L'intérêt de optim() est de pouvoir traiter des fonctions beaucoup plus complexes, comportant plusieurs paramètres. Mais elle peut converger vers un minimum local.
optim() est notamment utile pour l'estimation statistique lorsqu'on peut traduire le problème en une fonction objectif. Par exemple, certains estimateurs du maximum de vraisemblance sont calculés en maximisant une fonction de vraisemblance.
La fonction nlm() est proche de optim(), à savoir trouver le minimum d'une fonction numérique.
Pourquoi R propose-t-il deux fonctions, optim() et nlm(), qui semblent faire la même chose ? La différence tient surtout aux méthodes disponibles et aux possibilités de réglage. optim() propose plusieurs algorithmes, tandis que nlm() applique une méthode de type Newton et peut calculer une matrice hessienne qui décrit la courbure locale de la fonction. Cette matrice peut notamment être utile dans certains travaux d'estimation statistique.
Tenir compte de contraintes
Dans les problèmes réels, les paramètres ne peuvent pas prendre n'importe quelle valeur. Une entreprise ne peut pas produire une quantité négative, un budget doit respecter certaines limites, des proportions doivent rester positives et leur somme peut être soumise à une contrainte.
La fonction constrOptim() permet de minimiser une fonction tout en respectant des contraintes linéaires exprimées sous forme d'inégalités. Elle s'appuie sur les méthodes d'optimisation de optim() et utilise un algorithme de barrière pour maintenir la recherche dans la région autorisée.
Autres fonctions
Ces fonctions ne constituent pas une liste exhaustive. Le package stats comprend d’autres outils d’optimisation.
- nlminb() effectue une minimisation numérique et permet de définir des bornes inférieures et supérieures pour les paramètres. Elle constitue une autre possibilité lorsque les paramètres sont contraints.
- nls() réalise une estimation par moindres carrés non linéaires. Elle est particulièrement adaptée lorsqu'on cherche à ajuster un modèle non linéaire à des observations, par exemple une courbe de croissance.
- deriv() permet de calculer symboliquement des dérivées et de construire des fonctions qui les évaluent. Ces dérivées peuvent être utiles pour fournir des gradients à des algorithmes d'optimisation.
- optimHess() calcule une approximation numérique de la matrice hessienne d'une fonction au voisinage d'un point donné. Elle complète ainsi les possibilités de optim().
Ces fonctions répondent à différents besoins. Certaines sont des outils généraux d'optimisation tandis que d'autres sont destinées à des modèles statistiques particuliers ou à l'évaluation de dérivées.
Enfin, il faut distinguer l'optimisation numérique de l'estimation statistique au sens large. Une régression linéaire avec lm(), par exemple, ne nécessite pas l'emploi de optim() ou nlm(). R fournit des fonctions statistiques de plus haut niveau qui réalisent elles-mêmes les calculs nécessaires.